Gemini 3.8 Flash TTS: vozes com IA do Google
O Google anunciou o Gemini 3.8 Flash TTS e o Gemini 3.8 Flash-Lite TTS, modelos de text-to-speech voltados à criação de vozes expressivas, dublagem, audiobooks e agentes de voz. Segundo a publicação oficial, os recursos chegam ao Google AI Studio e à Gemini API com controles de sotaque, emoção, ritmo e interpretação por linha de roteiro. O anúncio é datado de 23 de setembro de 2026; portanto, esta cobertura reproduz as informações da fonte fornecida e deve ser atualizada quando a disponibilidade for confirmada para cada região.
Tabela de conteúdos
O que muda com os novos modelos de voz
O Gemini 3.8 Flash TTS é a versão direcionada à direção criativa: desenvolvedores podem descrever uma persona em linguagem natural e criar uma voz do zero. A proposta inclui papel, características vocais, sotaque e cadência em mais de 100 idiomas e dialetos. Já o Gemini 3.8 Flash-Lite TTS foi desenhado para alto volume e eficiência de custo, com foco em dublagem, conteúdo de áudio e agentes conversacionais.
Resposta rápida
Na prática, o Gemini 3.8 Flash TTS busca transformar a síntese de fala em uma ferramenta de atuação: além de ler um texto, o modelo interpreta instruções de performance, pausas, reações e mudanças de tom.
Recursos para personagens, diálogos e conteúdo longo
O anúncio destaca controles linha a linha. Em um roteiro, o criador pode indicar uma fala calma para atendimento, um sussurro para suspense ou uma reação como risada, suspiro e espanto. O sistema também prevê backchanneling — interjeições de escuta, como “uhum” — para tornar uma conversa menos mecânica. Para podcasts e audiobooks, a promessa é manter timbre, ritmo natural e qualidade em horas de geração, reduzindo a deriva de locutor.
- Criação de personagens por prompts descritivos.
- Biblioteca com mais de 2.000 vozes prontas.
- Diálogos nativos entre dois locutores distintos.
- Controle de tom, ritmo, timbre e sotaque.
- Geração multilíngue para localização e dublagem.
Replicação de voz exige consentimento
O ponto mais sensível é a replicação de voz. De acordo com o Google, uma amostra de 30 segundos pode servir para recriar um perfil vocal, desde que o usuário tenha direito de uso. Antes da criação, o sistema pede uma gravação de consentimento verbal do dono da voz e compara esse registro com o locutor de referência. Cada áudio gerado também recebe marca d’água imperceptível do SynthID, enquanto as credenciais C2PA ajudam a sinalizar a origem do conteúdo.
A tecnologia não elimina a responsabilidade editorial: clonagem de voz sem autorização pode causar fraude, desinformação e violação de direitos de personalidade.
Qualidade, idiomas e limites anunciados
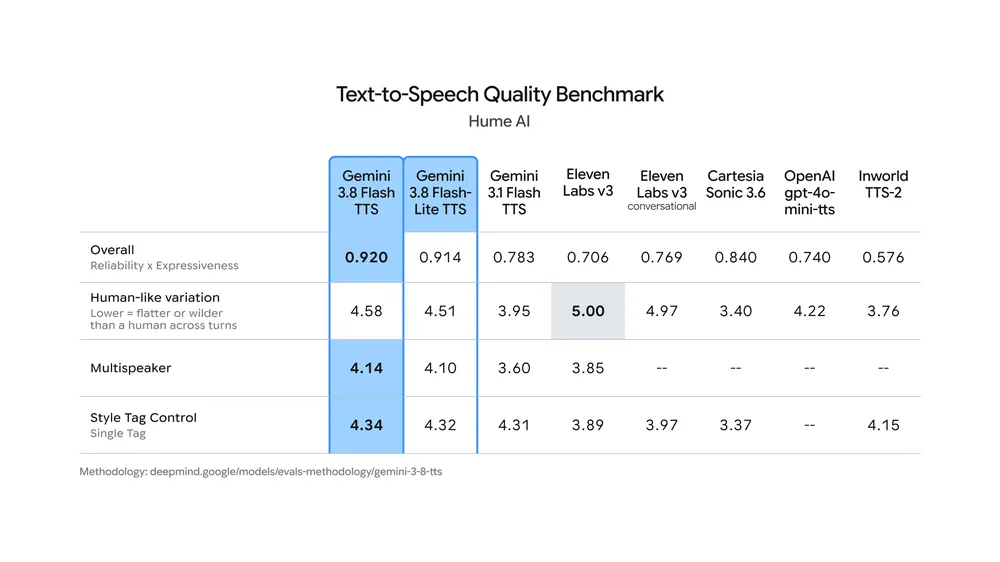
O Google afirma que o Gemini 3.8 Flash TTS ficou em primeiro lugar no Voice Design Benchmark da Hume AI, com 71,4 pontos, e liderou a modelagem de sotaque, com 60,8. A empresa também cita boas posições no Voice Arena para idiomas como português brasileiro, japonês, vietnamita, árabe padrão moderno, espanhol mexicano e hindi. Esses resultados são referências divulgadas pelo fabricante e devem ser lidos como indicadores comparativos, não como garantia de desempenho em todo projeto.
Onde usar Gemini 3.8 Flash TTS
| Modelo | Foco | Acesso informado |
| Gemini 3.8 Flash TTS | Personagens e direção criativa | Gemini API, AI Studio e Gemini Notebook |
| Gemini 3.8 Flash-Lite TTS | Escala e dublagem | Gemini API, AI Studio e Google Vids |
| Gemini Enterprise | Uso corporativo | Chegada futura via API, segundo o Google |
Para testar, a empresa aponta o playground de áudio do Google AI Studio e a documentação de geração de fala da Gemini API. Integrações com plataformas como Agora, LiveKit, Pipecat e Vercel foram citadas como caminhos para implantar interfaces de voz. Há uma restrição relevante: a replicação de voz no AI Studio não está disponível em Illinois, Texas, Espaço Econômico Europeu, Reino Unido, Suíça e Índia, conforme a nota do lançamento.
Perguntas Frequentes sobre Gemini 3.8 Flash TTS
O que é o Gemini 3.8 Flash TTS?
É o modelo de geração de voz mais criativo anunciado pelo Google. Ele cria vozes, controla a interpretação e monta diálogos a partir de texto e instruções em linguagem natural. O acesso foi informado via AI Studio e Gemini API.
Qual é a diferença para o Flash-Lite TTS?
O Flash prioriza direção de personagens e cenas detalhadas. O Flash-Lite TTS é otimizado para alto volume, eficiência de custo, dublagem e agentes de voz expressivos. Ambos oferecem controle de tom e ritmo.
O Gemini pode replicar qualquer voz?
Não de forma livre. O Google diz exigir consentimento verbal verificável e direitos sobre a voz de referência. A função também tem limitações geográficas no AI Studio, incluindo EEE e Reino Unido.
Como o áudio de IA é identificado?
O Google informa que todo clipe gerado pelos modelos Gemini Audio recebe SynthID. A marca d’água é imperceptível e busca facilitar a detecção de fala sintética e reduzir riscos de desinformação.
Considerações finais
O Gemini 3.8 Flash TTS amplia a disputa pela geração de voz por IA ao combinar personalização, diálogos de dois locutores e mecanismos de consentimento. Para criadores, a utilidade está em acelerar dublagem e produção de áudio; para empresas, em projetar agentes de voz com mais naturalidade. Antes de publicar qualquer material, porém, é essencial validar permissões, informar o uso de IA e revisar o resultado humano e editorialmente. Não foram fornecidos links de vídeos, posts incorporáveis do X, Instagram ou YouTube; por isso, nenhuma incorporação social foi inserida.
Fonte primária: blog oficial do Google; documentação indicada: Google AI Studio e model card do Gemini Audio.