TPU 8tx e TPU 8i Max: novos sistemas de IA do Google
O Google ampliou sua linha de aceleradores de inteligência artificial com os sistemas TPU 8tx e TPU 8i Max. O primeiro é voltado à computação confidencial; o segundo, a agentes que processam grandes volumes de informação. O texto, datado de 9 de novembro de 2026, informa que preços, regiões atendidas e datas de disponibilidade geral não foram divulgados.
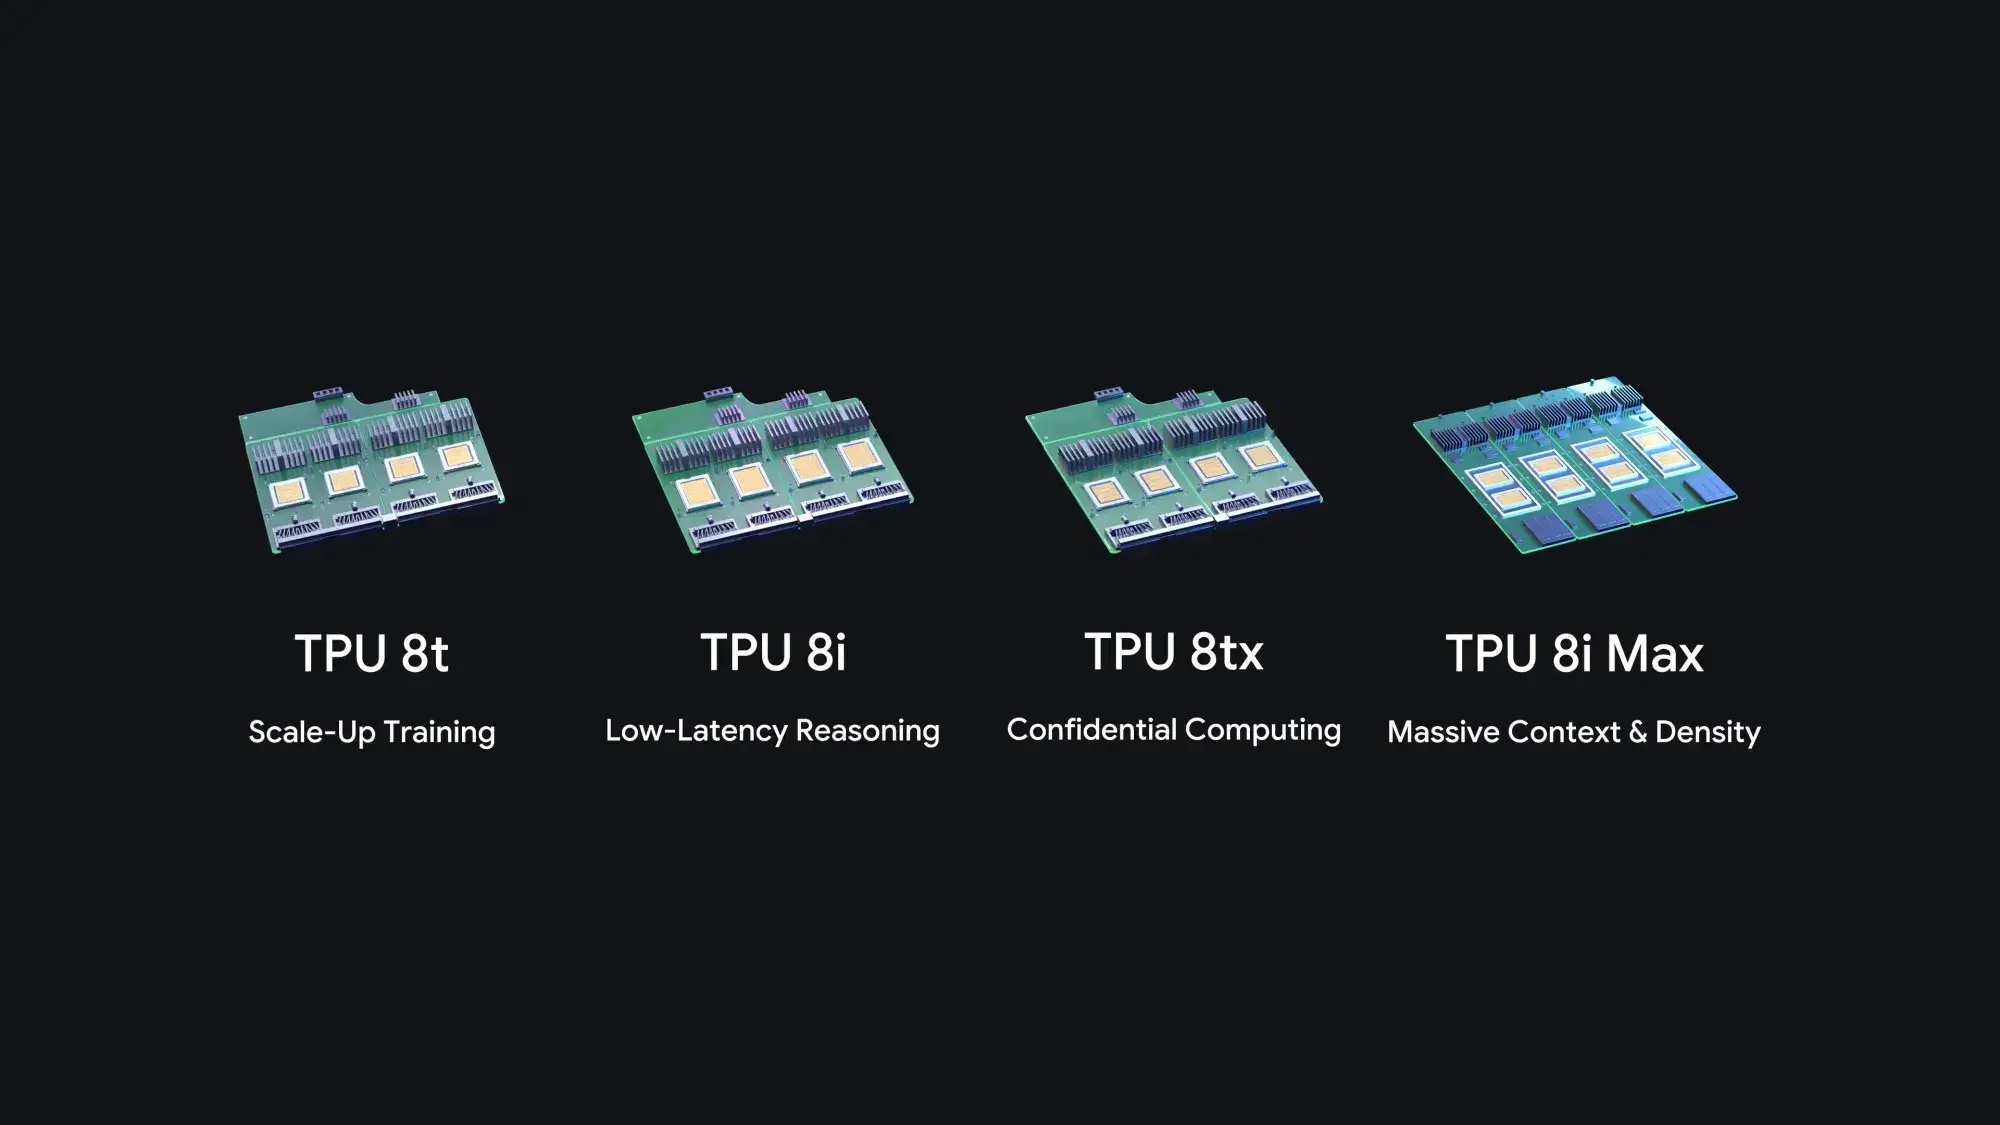
As configurações se juntam à TPU 8t, destinada ao treinamento em larga escala, e à TPU 8i, voltada ao raciocínio com baixa latência. Em vez de apresentar dois chips inteiramente novos, a empresa teria reorganizado componentes existentes para atender a necessidades diferentes de segurança, capacidade e memória.
Tabela de conteúdos
Qual é a diferença entre TPU 8tx e TPU 8i Max?
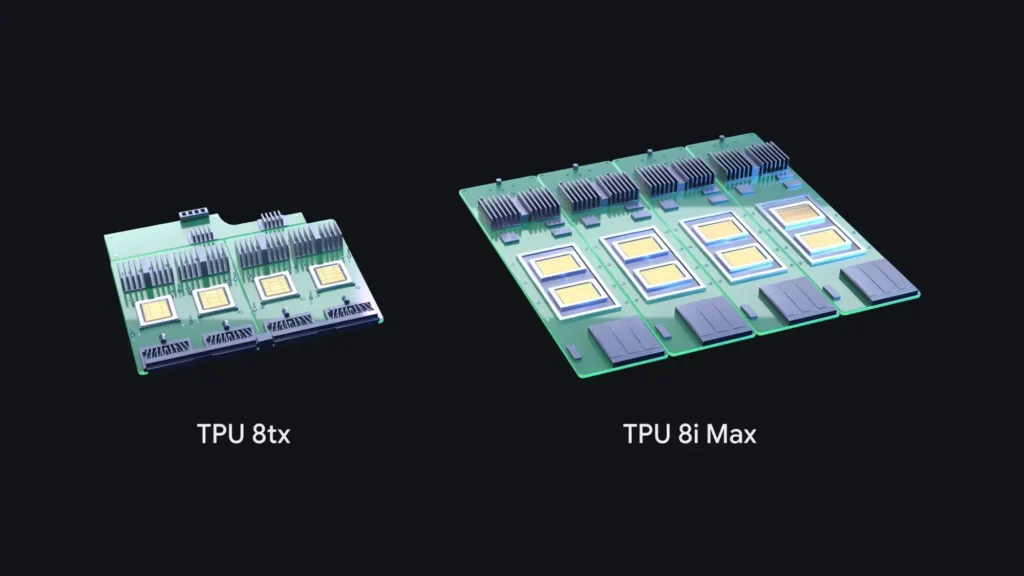
A principal diferença está na finalidade. A TPU 8tx usa o silício da TPU 8t e acrescenta recursos de segurança em hardware para cargas sensíveis. Já a TPU 8i Max reúne dois chips TPU 8i em um único encapsulamento, com foco em tarefas que exigem mais processamento e largura de banda de memória.
| Sistema | Base | Foco |
|---|---|---|
| TPU 8t | Silício TPU 8t | Treinamento em larga escala |
| TPU 8i | Silício TPU 8i | Raciocínio de baixa latência |
| TPU 8tx | Silício TPU 8t | Computação confidencial |
| TPU 8i Max | Dois chips TPU 8i | Agentes e cargas intensivas em memória |
TPU 8tx: proteção para dados durante o processamento
A TPU 8tx é direcionada a empresas de setores regulados e órgãos públicos que usam modelos ou agentes de IA com dados sensíveis. Segundo o material, ela combina o silício da TPU 8t com CPUs AMD personalizadas e mecanismos de computação confidencial em hardware.
Essa abordagem busca proteger dados e pesos dos modelos enquanto estão sendo processados, complementando a criptografia usada no armazenamento e na transmissão. A proteção, porém, não elimina a necessidade de controles de acesso, configuração adequada e avaliação dos requisitos de cada organização.
A configuração também utiliza a rede Boardfly, desenvolvida para a TPU 8i. De acordo com a reportagem, o Google afirma que o conjunto pode alcançar até duas vezes o desempenho da TPU 8t, com impacto quase nulo dos recursos de segurança. São alegações da empresa, e o texto fornecido não detalha as condições dos testes.
Além de inferência, a TPU 8tx é apresentada como opção para treinamento de menor escala, ajuste fino privado, destilação de modelos e aprendizado por reforço. A proposta é realizar essas etapas em um mesmo sistema, reduzindo a necessidade de transferir informações sensíveis entre clusters separados.
TPU 8i Max amplia processamento e largura de banda
A TPU 8i Max foi pensada para agentes que precisam lidar com bases extensas de código, vídeos longos e contextos que chegam a um milhão de tokens. Tokens são unidades usadas pelos modelos para processar texto e outras informações; contextos maiores podem exigir mais recursos de memória durante a execução.
Segundo o Google, o pacote com dois chips oferece o dobro de capacidade de processamento, SRAM e largura de banda da memória HBM em relação à TPU 8i. A empresa também afirma acomodar o dobro de silício no mesmo espaço de rack, aumentando a densidade computacional.
Como referência, as especificações citadas para a TPU 8i incluem 288 GB de HBM, 384 MB de SRAM e largura de banda de memória de 8.601 GB/s. Isso não significa que a capacidade absoluta de HBM da TPU 8i Max seja automaticamente o dobro: o anúncio resumido na reportagem não informa esse número.
Ferramentas de software e memória para agentes de IA
O hardware vem acompanhado de ferramentas para facilitar a execução de modelos. O TorchTPU oferece suporte à execução nativa de PyTorch, enquanto vLLM e SGLang contam com backends para TPUs. A empresa também anunciou o XLA Serving Engine, projeto de código aberto para servir modelos em TPUs, GPUs e CPUs por meio de um ambiente de execução em C++.
Uma suíte de agentes para TPU, em prévia, é descrita como compatível com Claude Code, Cursor e Google Antigravity. Ela pretende auxiliar na configuração, no diagnóstico de desempenho e no ajuste de kernels personalizados. O Agent Compute Engine, por sua vez, suspende sessões ociosas e retira sua memória de trabalho do acelerador, segundo o Google.
Outro componente, o TPU Sync, coordena camadas como HBM, DRAM e armazenamento para transferir o cache KV, que guarda estados usados durante a inferência. A empresa relata reduções superiores a 90% na latência de transferência do cache e no tempo até o primeiro token. Sem as condições do teste, não é possível extrapolar esses números para todas as aplicações.
Google Cloud: disponibilidade e gestão dos clusters
A reportagem afirma que o Cloud Pathways está em disponibilidade geral no Google Kubernetes Engine. O ambiente permite administrar várias fatias de TPU por um controlador, para treinamento, aprendizado por reforço e inferência. O fatiamento dinâmico do GKE também teria chegado à disponibilidade geral, permitindo combinar ou dividir recursos conforme a carga.
Essas informações sobre software não devem ser confundidas com a disponibilidade dos novos sistemas: o texto não informa quando TPU 8tx e TPU 8i Max estarão disponíveis para todos os clientes, nem apresenta preços ou regiões atendidas. O Google também cita ganhos de inicialização e recuperação, mas resultados reais dependerão da configuração e do trabalho executado.
Perguntas frequentes sobre TPU 8tx e TPU 8i Max
A TPU 8tx usa um chip totalmente novo?
Não. A TPU 8tx usa o silício da TPU 8t em uma configuração com recursos adicionais de computação confidencial e CPUs AMD personalizadas.
Para que serve a TPU 8i Max?
Ela é voltada a agentes e outras cargas intensivas em memória, como o processamento de bases de código extensas e contextos longos.
Qual é a capacidade de memória HBM da TPU 8i Max?
A capacidade absoluta não foi informada no texto fornecido. O dobro anunciado se refere à largura de banda HBM, não necessariamente à capacidade.
Quanto custam TPU 8tx e TPU 8i Max?
A reportagem não informa preços, regiões atendidas ou datas de disponibilidade geral para os dois novos sistemas.
Fontes: anúncio do Google, a descrição técnica da TPU 8t e da TPU 8i e a publicação sobre vLLM e SGLang.