EmbeddingGemma 2: IA multimodal para uso local
O Google anunciou o EmbeddingGemma 2, modelo aberto de embeddings multimodais criado para executar busca semântica, recuperação de dados e RAG diretamente no dispositivo. Publicada pela Google DeepMind em 6 de outubro de 2026, a novidade reúne texto, código, imagens, áudio e vídeo em um mesmo espaço de embeddings. Com 740 milhões de parâmetros, licença Apache 2.0 e foco em inferência local, a proposta é permitir que apps encontrem informações relacionadas sem transferir conteúdo sensível à nuvem.
Em termos práticos, o EmbeddingGemma 2 transforma diferentes formatos de conteúdo em vetores comparáveis, permitindo pesquisar uma fala, uma foto ou um trecho de vídeo com uma consulta em texto.
Tabela de conteúdos
O que muda com o modelo multimodal
Um embedding representa o significado de um conteúdo como uma sequência numérica. Ao comparar esses vetores em um banco de dados vetorial, um sistema encontra itens semanticamente semelhantes, mesmo quando não há coincidência literal de palavras. A primeira versão do EmbeddingGemma era voltada a texto. A versão 2 amplia esse princípio para mídia e código, com um único modelo nativamente multimodal.
- Buscar um clipe de vídeo a partir de um memorando de voz.
- Localizar fotos por descrição textual ou imagem de referência.
- Indexar código e melhorar a recuperação de agentes de programação.
- Executar RAG privado com arquivos preservados no aparelho.
- Classificar e rotear conteúdo multimodal em tempo real.
Números, memória e qualidade declarada
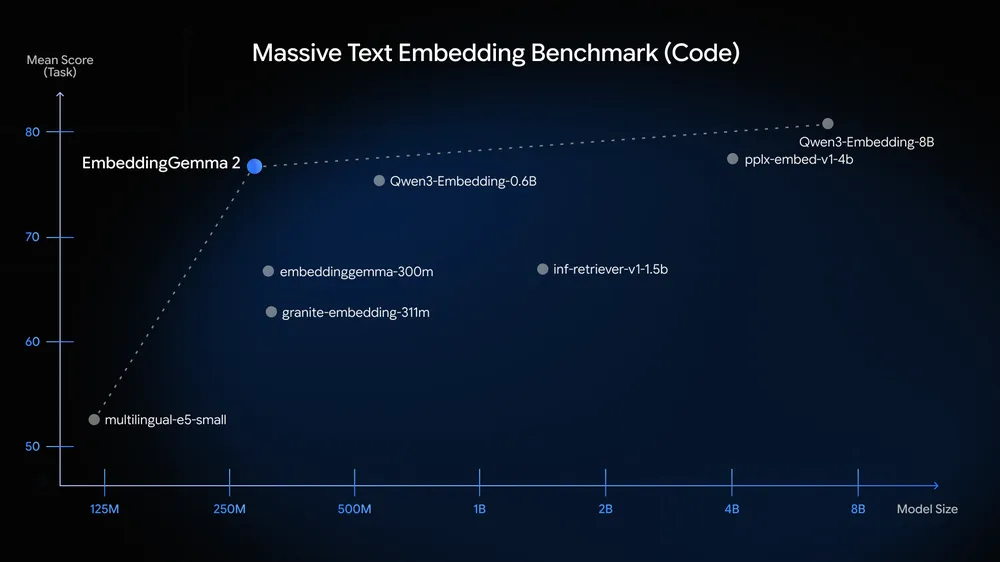
Segundo o anúncio, o EmbeddingGemma 2 lidera sua faixa de tamanho modelos multimodais abaixo de 1 bilhão de parâmetros em referências como MTEB Code e MAEB. No MTEB Code, a pontuação informada sobe de 68,76 para 78,68 em relação ao EmbeddingGemma anterior: ganho de 9,92 pontos. Esses resultados devem ser lidos como métricas divulgadas pelo próprio fornecedor; a comparação prática depende do conjunto de dados, idioma, hardware e tarefa de cada equipe.
| Recurso | Dado informado | Impacto para desenvolvimento |
| Parâmetros | 740 milhões | Foco em execução no dispositivo |
| Contexto | 8 mil tokens | Até 5,5 minutos de áudio ou 58 frames |
| Vetores | 768 a 128 dimensões | Até 6x menos armazenamento |
| Memória no Pixel 11 Pro | 191 MB a 567 MB | Varia conforme modalidade e quantização |
Vetores menores e execução offline
O modelo usa Matryoshka Representation Learning (MRL), técnica que permite truncar a saída de 768 dimensões para 512, 256 ou 128 dimensões. A consequência é uma economia de espaço em índices locais, anunciada em até seis vezes. Isso interessa a produtos que armazenam muitos documentos, imagens ou registros de áudio, nos quais o tamanho do índice afeta custo, memória e velocidade de consulta.
Privacidade não elimina a necessidade de governança
Processar embeddings no aparelho reduz o envio de dados a servidores, mas não substitui controles de acesso, criptografia, política de retenção e avaliação de vieses nos resultados.
Como o EmbeddingGemma 2 se integra a apps
A Google sugere combinar o modelo com Gemma 4: o EmbeddingGemma 2 recupera arquivos relevantes e o modelo generativo produz contexto ou respostas. Como compartilham tokenizer de texto e codificador de áudio, a empresa afirma que a dupla pode ter menor pegada de memória. Para implantação, há suporte citado para MediaPipe e LiteRT, além de transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama, LM Studio e Qdrant.
Os pesos estão disponíveis no Hugging Face e no Kaggle. Desenvolvedores também podem testar exemplos no Google AI Edge Gallery, como Instant Media Search e Video Moments Finder. Antes de levar o recurso à produção, vale medir latência, consumo de bateria, precisão de recuperação e qualidade em português especialmente se o acervo tiver termos regionais, gravações ruidosas ou documentos especializados.
“EmbeddingGemma 2 is the most capable model for on-device multimodal embeddings.”
Google DeepMind, anúncio de lançamento
O que observar antes da adoção
O anúncio não substitui uma validação independente. Benchmarks medem cenários controlados e podem não refletir a base de dados de uma empresa. Também é preciso verificar compatibilidade com o dispositivo-alvo, licença de componentes adicionais, limites de memória e estratégia de atualização do índice vetorial. Para casos de busca de vídeo por áudio, por exemplo, a qualidade da transcrição e a seleção de frames influenciam diretamente a experiência.
Perguntas frequentes sobre EmbeddingGemma 2
O que é o EmbeddingGemma 2?
É um modelo aberto do Google para criar embeddings multimodais. Ele representa texto, código, imagens, áudio e vídeo em vetores comparáveis para busca e recuperação local.
O EmbeddingGemma 2 funciona offline?
Pode funcionar localmente, conforme o hardware e a integração adotada. A execução no dispositivo reduz a dependência da nuvem e favorece fluxos de RAG privado.
Qual é o tamanho do EmbeddingGemma 2?
O modelo tem 740 milhões de parâmetros. Para texto, a configuração pode usar 270 milhões; visão e áudio são encoders opcionais para o modo multimodal.
Onde baixar o EmbeddingGemma 2?
Os pesos foram publicados no Hugging Face e no Kaggle. A documentação da Google AI traz instruções de inferência, ajuste fino e implantação com LiteRT e MediaPipe.
Considerações finais
O EmbeddingGemma 2 reforça a disputa por IA multimodal menor, aberta e executada no dispositivo. Sua combinação de busca semântica, vetores ajustáveis, contexto ampliado e integração com Gemma 4 pode ser especialmente útil em produtos que priorizam privacidade e baixa latência. A decisão de adoção, porém, deve partir de testes reproduzíveis com dados reais, e não apenas dos benchmarks divulgados.
Fonte primária: anúncio da Google DeepMind; model card do EmbeddingGemma 2.